
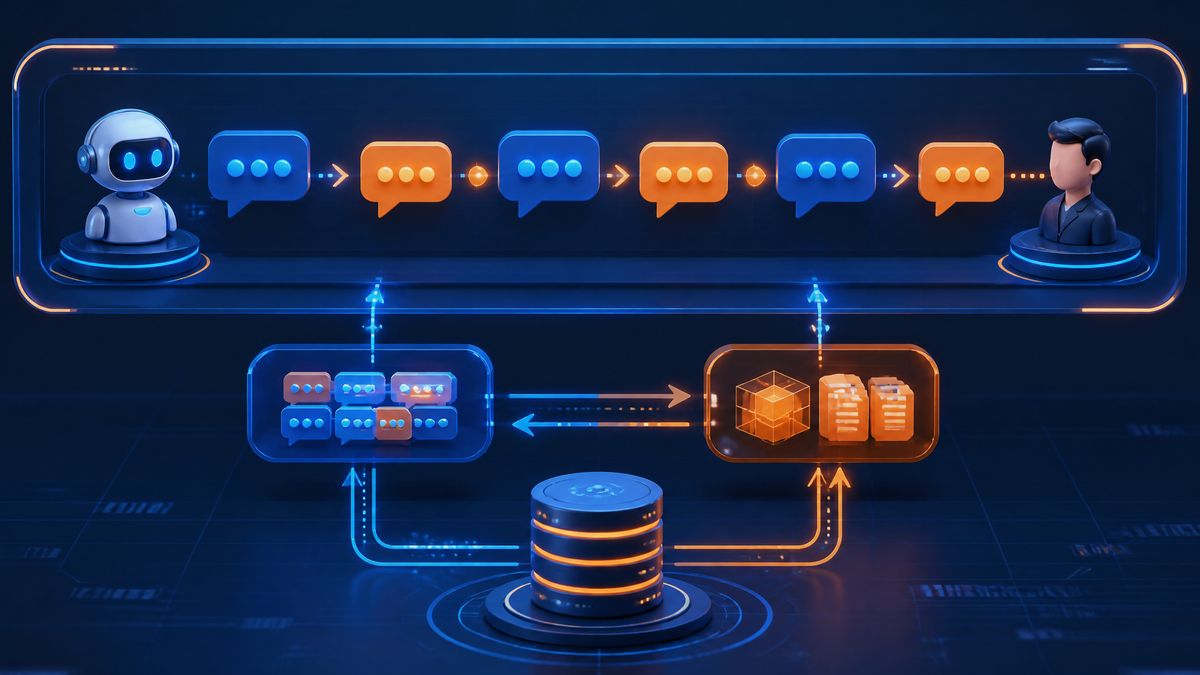
有个做企业服务的客户去年上了个客服Agent,刚上线那两周效果还行,用户问什么答什么。到了第三周问题来了——一个客户上午聊了半小时选了三个服务方案,下午回来问”我上午选的那个方案多少钱来着”,Agent完全不知道他在说什么,把上午的对话忘得一干二净。客户跟我吐槽说”你这Agent跟金鱼似的,三秒记忆”。
我查了日志发现不是Agent不愿意记住,是技术架构上就没做多轮对话的上下文管理。每次用户发消息过来,Agent只看当前这一条消息做回答,之前的对话历史压根没传进去。这就像你跟一个人聊天,他每句话都当作全新的对话来理解,你说的任何前文他全不知道。这种Agent能处理简单的一问一答,但碰到需要上下文的连续对话就歇菜。
后来我帮他重新设计了多轮对话架构,加了上下文窗口管理和长期记忆两层机制。改完之后那个客户回来问上午的方案,Agent能从记忆里捞出来接着聊。整个过程改了三周,我把他拆开讲,做Agent开发的人看完就知道多轮对话该怎么搞。
对话状态机是什么东西
做多轮对话设计,先得理解对话状态机这个概念。别被名字吓到,说直白点就是:对话进行到不同阶段,Agent的关注点不一样。用户刚来的时候处于”意图识别”阶段,Agent要搞清楚他想干什么。搞清楚之后进入”信息收集”阶段,Agent要追问缺失的关键参数。参数齐了进入”方案生成”阶段,Agent给出回答。用户对回答有疑问就进入”澄清确认”阶段。每个阶段的对话策略、追问逻辑和回答模板都不一样。
我那个企业服务客户的客服Agent原来没有状态机,所有消息用同一套逻辑处理。用户问”公司注册多少钱”,Agent回答了价格。用户接着问”包不包括地址”,Agent又把地址费用单独报了一遍,但它不知道用户已经在问公司注册的总价了,所以报的地址费用没有跟注册费用关联起来。加了状态机之后,Agent知道用户处于”公司注册咨询-费用确认”这个状态,追问地址费用时自动关联到注册总价上下文,回答的时候会说”地址托管500元/年,加上注册0元代办,你实际只需要付地址费用”,而不是孤立地报一个数字。
状态机设计的关键是定义清楚有哪些状态、状态之间怎么跳转。我的做法是画一张状态图,每个圆圈是一个对话状态,箭头是跳转条件。比如从”意图识别”跳到”公司注册咨询”的条件是用户消息里包含注册相关的关键词。从”公司注册咨询”跳到”信息收集”的条件是Agent确认了用户想注册公司但还不知道注册地、公司类型等关键信息。这张状态图不需要很复杂,我那个客服Agent一共定义了十二个状态、三十几条跳转规则,覆盖了百分之九十的常见对话场景。剩下百分之十的边缘场景用通用兜底逻辑处理——当Agent无法判断当前状态时,退回到”意图识别”重新走一遍。
有个设计陷阱提醒一下:状态跳转别搞成死规则。用户对话不会老老实实按你设计的流程走,他可能从”信息收集”阶段突然跳回去问一个完全不相关的问题。你的状态机要能处理这种”跳脱”。我的做法是每轮对话先做一次意图识别,如果发现用户意图变了,就保存当前状态、跳到新状态处理完用户的问题、再问用户要不要回到之前的话题。这个设计让Agent既能处理用户的跳脱,又不丢失之前的对话上下文。
上下文窗口怎么管才不会爆
状态机解决了”现在该关注什么”的问题,上下文窗口解决的是”之前的对话怎么传给大模型”的问题。大模型有一个硬限制叫上下文窗口长度——DeepSeek是六万四千Token,GPT-4o是十二万八千Token。听起来很大,但多轮对话里Token消耗速度超出你想象。用户每说一句话加上Agent的回答,平均消耗三四百Token。聊到第三十轮,对话历史就超过一万二Token了。如果你还往prompt里塞了知识库检索结果和业务规则文档,Token总量轻松突破两万。继续聊下去迟早会撞到窗口上限。
撞到上限会怎样?大模型API直接报错,对话中断。就算没撞到上限,对话历史太长也会导致两个问题:一是回答变慢——Token越多推理时间越长,二是注意力分散——大模型在超长上下文里容易”忘记”前面的关键信息,因为它对全文的注意力被稀释了。所以上下文窗口管理不是可选项,是必须做的。
我用的是滑动窗口加摘要截断的组合策略。滑动窗口就是只保留最近N轮对话历史传给大模型,超出窗口的历史不传。N设多少取决于你的业务场景,我那个客服Agent设的是最近八轮。为什么是八轮?因为我统计过用户的对话长度分布,百分之八十五的对话在十轮以内结束,八轮历史足以覆盖绝大部分需要上下文理解的场景。超出八轮的历史怎么处理?不是直接扔掉,而是用大模型生成一段摘要——把第九轮到第三十轮的对话压缩成两百字的摘要,放在对话历史的最前面。这样Agent既不会因为历史太长爆窗口,也不会完全丢失早期对话的关键信息。
摘要生成的时机有讲究。不是每轮对话都摘要一次,那样API成本太高。我设的触发条件是对话历史Token超过窗口的百分之七十时触发一次摘要。摘要由一个单独的大模型调用完成,用的模型比主对话模型便宜——主对话用GPT-4o,摘要用DeepSeek,成本能省一半。摘要prompt要明确告诉模型”提取对话中的关键事实和用户已确认的信息,不要记录寒暄和无效内容”,这样摘要质量才高。我调了好几版prompt才让摘要的准确率达到可接受的水平,第一版摘要漏掉了用户选择的服务方案,导致Agent”忘记”了用户的选择,跟之前金鱼记忆的问题一模一样。
长期记忆策略怎么设计
上下文窗口解决的是单次对话内的记忆问题,长期记忆解决的是跨对话的记忆问题。用户上午聊完关了窗口,下午再打开,Agent还能记得上午聊了什么。甚至上周聊的都能记住。这才是真正有用的Agent。怎么做到?靠的是外部记忆存储,不是靠大模型自己记。大模型是无状态的,每次调用都是独立的,它不会”记住”任何东西。记忆的实现方式是在对话开始时,从外部数据库里读取跟当前用户相关的历史信息,注入到prompt里。
我那个客服Agent的记忆存储用的是向量数据库加结构化数据库的组合。向量库存的是对话历史中提取的关键信息——用户提过的公司名、行业、需求描述、选择过的方案。每条信息存成一个向量,用用户ID关联。用户下次来对话时,Agent先用用户当前的消息去向量库里检索相关历史信息,把检索到的信息注入prompt的上下文里。结构化数据库存的是确定性的用户画像——用户类型、累计咨询次数、已购买的服务、当前在办的业务流程进度。这些信息是事实性的,不需要模糊检索,直接查表就行。
记忆的写入和更新策略是关键。不是每轮对话都往记忆库里写东西,那样噪音太大。我的做法是每轮对话结束后做一次信息提取——从对话中识别出”事实性信息”和”用户意图”。事实性信息写进结构化数据库,比如用户说了公司名”XX科技有限公司”就更新用户画像。用户意图写进向量库,比如用户表达了”想了解商标注册流程”就存一条意图记录。信息提取也是用大模型做的,每轮对话额外调一次API,成本大概增加百分之十五,但记忆质量提升非常明显。我做过对比,不加信息提取的记忆准确率只有百分之四十五,加了之后拉到百分之八十二。
记忆也有过期机制。不是所有信息都需要永久保存。寒暄、闲聊、已经解决的问题这类信息我设的过期时间是二十四小时,过了就自动清理。用户画像和已购服务信息是永不过期的。意向性信息——比如”想了解商标注册”——过期时间是三十天,超过三十天用户没再提到就降级为历史记录,不再主动注入上下文。过期机制是为了控制记忆库的噪音,你存的东西越多越杂,检索精度反而越低。
多轮对话的异常处理
多轮对话设计得再好,总会碰到异常情况。用户突然切换话题、消息内容Agent理解不了、上下文检索返回了错误的历史信息、大模型API超时——这些异常不处理好的话,Agent会给出莫名其妙的回答,用户体验直线下降。
我的异常处理框架分三层。第一层是输入校验:用户消息进来先过一遍安全检查和意图识别,如果意图识别置信度低于阈值就触发兜底逻辑——Agent回复”我不太确定您想了解什么,能再说详细一点吗”,而不是硬猜一个可能错的答案。第二层是上下文校验:从记忆库里检索到的历史信息跟当前对话做一次相关性检查,如果相关度低于阈值就不用这条历史。比如用户上午聊了公司注册,下午突然问商标注册,上午的注册对话相关性低就不用注入,避免上下文污染。第三层是输出校验:Agent生成回答后,用规则引擎检查一遍——回答里有没有不该出现的信息,格式对不对,有没有超出Agent的权限边界。三层校验过了才返回给用户,任何一层没过就走兜底流程。
异常处理的兜底流程不是让Agent道歉”我回答不了”,而是平滑转人工。我设计的转人工触发条件有三个:同一问题用户连续追问三次(说明Agent没答对),用户主动要求人工服务,Agent回答置信度低于百分之六十。转人工的时候Agent会把当前对话的上下文摘要发给人工客服,让人工接手时能看到之前聊了什么,不用用户重述一遍。这个细节看着小,但用户感受差别巨大——不卡顿地转人工是Agent体验的分水岭。做Agent多轮对话的同行们,上下文和记忆这两块一定要下足功夫,这是Agent能不能从”玩具”变成”工具”的关键。有拿不准的地方可以聊聊,帮你诊断下你的多轮对话架构缺了哪一层。
需要相关服务?联系我们免费咨询
九五星球企服提供公司注册、代理记账、商标注册、财税咨询、高新申报、网站开发等一站式企业服务。可以先免费咨询看看,觉得合适再合作,不推销。
免费小工具推荐:
联系方式:
- 电话/微信:18910232032
- 扫码添加专业经营合规顾问,免费咨询 ↓
