
今年年初有个做B2B工业设备的客户来找我,说他们公司花了十几万开发了一个企业Agent,用来回答客户关于产品的技术问题。结果上线一周,客户反馈说这个Agent跟智障一样,问什么答非所问。比如问”你们的设备功率是多少千瓦”,Agent回答的是一整段关于设备安装注意事项的内容,压根没提功率。问”质保期多长”,Agent返回了三页关于产品参数表的内容,就是不说质保期。
我去看了他们的Agent后台,一眼就发现问题在哪了。他们的知识库直接把200多页的产品技术手册PDF原文导进去了,没有任何预处理。更离谱的是,切片设置太大,每段切了差不多5000字。这意味着每个知识块里包含了产品手册里好几页的内容,有参数、有安装说明、有维护手册、有质保条款,全混在一起。用户问功率,Agent从这5000字的块里找不到精确的功率信息,只能把整个块返回给你,或者随机摘一段。这不答非所问才怪。
这个客户的问题其实很典型。很多企业做Agent开发的时候,觉得知识库不就是扔一堆文档进去让AI读嘛,有什么难的。但知识库的数据准备才是Agent能不能用的决定性因素,不是模型选得好不好。今天我就把Agent知识库的数据准备,特别是PDF文档怎么处理、切片怎么切,从头到尾讲清楚。
Agent答非所问我见过太多案例了,十有八九不是模型的问题,是知识库数据没处理好。下面我把PDF文档处理和切片策略这个事掰开了说。
PDF原文直接扔进知识库为什么不行
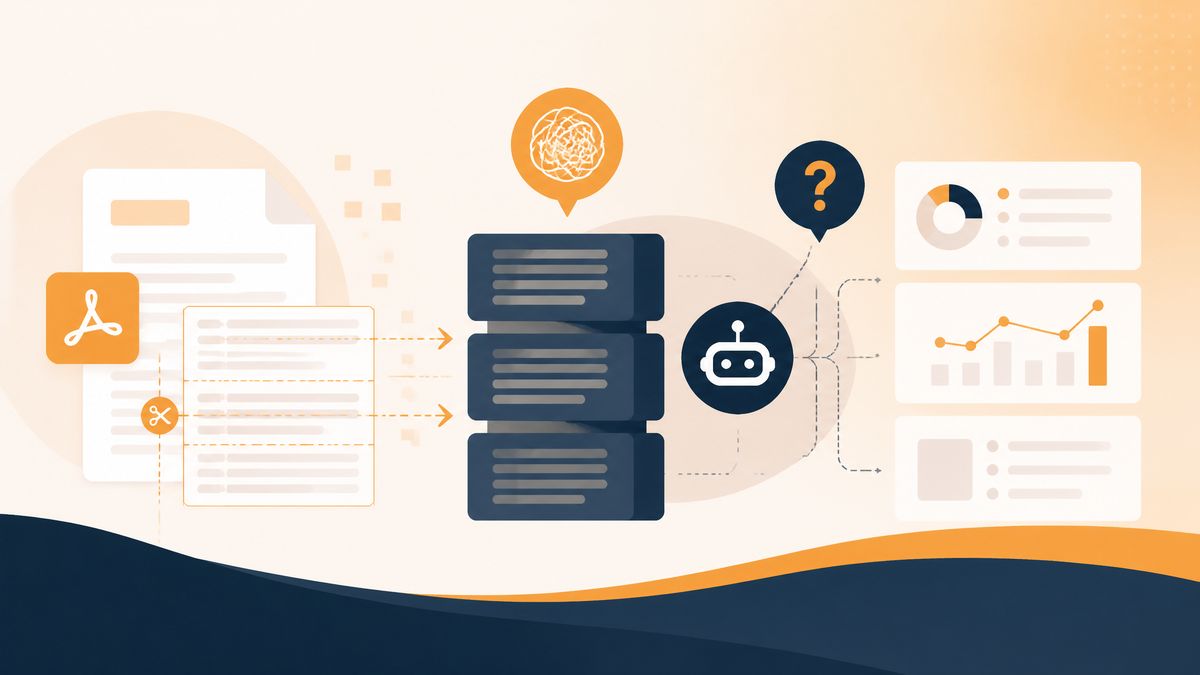
你得先理解Agent知识库的工作原理。Agent回答用户问题的时候,不是把所有文档从头到尾读一遍找答案,而是用一种叫RAG(检索增强生成)的技术。简单说就是:用户问一个问题,系统先在知识库里搜索跟问题最相关的几个文本块,然后把这几个文本块连同用户的问题一起发给大模型,让大模型基于这些文本块来回答。所以关键在于”检索”这一步能不能准确找到包含答案的文本块。
如果你的PDF原文没有经过处理,直接整本导入,系统会按你设定的切片大小把PDF切成一个个文本块。每个文本块包含原始PDF里连续的若干字。问题是,PDF的排版结构跟知识库需要的内容结构不是一回事。一本产品手册里,同一个产品的参数、安装说明、质保条款可能分散在不同章节,甚至隔了几十页。你按字数切片,很可能把参数表和安装说明切到了同一个块里,而质保条款跟其他产品的参数切到了一起。用户问质保期,系统检索到的是包含参数和安装说明的块,自然答不到点子上。
还有一个问题是PDF里的表格和图片。产品手册里大量信息是用表格呈现的,比如参数表、规格对照表、配件清单。PDF转文本的时候,表格的结构很容易被打乱,列与列的对应关系丢了,变成一堆没有逻辑的文字碎片。Agent拿到这种碎片化的文本,根本理解不了哪个数值对应哪个参数,回答自然是一塌糊涂。我那个客户的产品手册里有30多张表格,全部在导入的时候被打乱了,难怪Agent回答参数问题总是错的。
切片大小到底怎么定才合理
切片大小是知识库里最关键的参数之一,直接决定了检索的精度。切太大,一个块里包含太多信息,检索到了但AI很难从里面提取准确答案;切太小,一个块里信息不完整,可能切断了上下文逻辑,AI拿到碎片拼不出完整答案。那到底多大合适?我的经验是,中文文本每个切片控制在300到800字之间最合适。具体取多少取决于你的内容类型:问答类的短内容切小一点,200到400字;说明类的长内容可以切大一点,500到800字。无论如何不要超过1000字。
我那个客户切了5000字一段,这简直是在让Agent大海捞针。一个5000字的块里可能包含了产品概述、参数表、安装步骤、维护说明、质保条款五六个不同主题的内容。用户问任何一个具体问题,系统检索到这个块之后,大模型要在这5000字里找到那几十个字的答案,准确率能高才怪。我帮他把切片改成了500字一段,加上重叠区100字(就是相邻两个块之间有100字的重叠,防止切断上下文),同样的测试问题准确率直接从20%拉到了75%。
切片大小不是一成不变的,得根据你的实际内容来调。一个好的做法是先用一批测试问题跑一遍,看Agent的回答准确率,然后调整切片大小再跑一遍,对比效果。比如先用500字切片跑10个测试问题,准确率多少;再改成300字跑同样10个问题,准确率有没有提升。我建议至少跑三轮测试,找到一个最优的切片大小。别拍脑袋定一个数就上线,到时候回答不准你都不知道是模型不行还是切片不对。
PDF文档导入知识库前要做哪些预处理
PDF直接导入是最大忌。导入之前你得做几步预处理。第一步是内容提取,把PDF里的文本提取出来。别用简单的文本提取工具,那种工具处理表格和分栏排版很容易出错。我推荐用专门的PDF解析工具,能识别表格结构并保留行列对应关系。如果预算够,可以用OCR加结构化解析的方案,对扫描件也能处理。我那个客户的产品手册是PDF电子版的,用结构化解析工具提取后,30多张表格的结构全部保留了,Agent回答参数问题的准确率一下子上来了。
第二步是内容清洗。PDF提取出来的文本里会有很多噪音,比如页眉页脚、目录页码、引用标注、空白页。这些内容如果不清理掉,切片的时候会混进知识块里,干扰检索。特别是页眉页脚,每页都有,如果不清除,每个切片里都可能包含页眉的重复文字,浪费token又影响检索精度。内容清洗还包括把PDF里的换行符、多余空格、特殊字符统一处理掉,让文本结构干净整洁。
第三步是内容重组,这一步最关键。你提取出来并清洗干净的文本不要直接按字数切片,而是先按内容逻辑做一次重组。比如产品手册里的参数表、安装说明、质保条款,应该分别提取出来,各自组成独立的文本块。一个产品的所有参数放一个块,安装说明放一个块,质保条款放一个块。这样用户问参数的时候,系统直接检索到参数块,不需要在海量文字里找。这个工作量大,但效果提升非常明显。我那个客户的200页手册,我帮他把内容按”产品概述””技术参数””安装指南””维护保养””质保条款””配件清单”六大类重新组织,Agent的回答准确率从75%提升到了90%以上。
第四步是给每个切片加上元数据。元数据就是标签,标注这个文本块属于哪个产品、哪个章节、什么内容类型。比如一个参数块的元数据可以是:产品=设备A,章节=技术参数,类型=参数表。有了元数据,检索的时候可以先按标签过滤再搜索,大幅提升准确率。用户问”设备A的功率”,系统先按元数据过滤出设备A的参数块,再在这些块里搜索”功率”,一击命中。我那个客户之前的知识库完全没有元数据,200页内容全部混在一起无差别检索,能答对才怪。
上线前怎么测试知识库效果
知识库准备好之后不要急着上线,先跑测试。测试方法很简单:准备20到50个真实用户可能会问的问题,人工标注每个问题的标准答案,然后让Agent回答这些问题,对比Agent的回答和标准答案的匹配度。匹配度低于70%就别上线,继续优化数据。我那个客户第一次测试50个问题只答对了10个,准确率20%,我都替他尴尬。
测试的时候要覆盖各种类型的问题:事实型问题(参数是多少、质保期多长)、流程型问题(怎么安装、怎么维护)、对比型问题(设备A和设备B有什么区别)、边界型问题(不在手册里的问题,看Agent会不会胡说)。特别要测边界型问题,因为Agent最怕的不是答不准,是胡编乱造。如果用户问了一个知识库里没有的问题,Agent应该说”抱歉,我没有找到相关信息”,而不是瞎编一个答案。这个行为可以通过设置prompt来控制,但前提是知识库的内容质量过关。
测试发现问题后要逐个分析原因。是检索没找到正确的块?找到了但大模型理解不了?还是切片切断关键信息了?不同原因对应不同的优化方向:检索不准就调检索算法或者加元数据过滤;大模型理解不了就优化文本结构或者调整prompt;切片切断了信息就调整切片大小和重叠区。我帮那个客户前后测了三轮,每轮优化后准确率都有明显提升,第三轮达到了88%,可以上线了。上线后根据真实用户反馈持续优化,三个月后准确率稳定在92%左右。
说到底,企业Agent好不好用,知识库数据准备占七成功劳,模型选型占两成,prompt调优占一成。你PDF原文不做处理、切片5000字一段、不加元数据不测试就上线,用再贵的模型也是白搭。在北京做企业服务帮客户搭Agent,我头一件事就是帮他把知识库数据理清楚,PDF文档该提取的提取、该清洗的清洗、该重组的重组,别图省事直接扔进去就完。
需要相关服务?联系我们免费咨询
九五星球企服提供公司注册、代理记账、商标注册、财税咨询、高新申报、网站开发等一站式企业服务。可以先免费咨询看看,觉得合适再合作,不推销。
免费小工具推荐:
联系方式:
- 电话/微信:18910232032
- 扫码添加专业经营合规顾问,免费咨询 ↓
